目标识别是比单一的图像识别要复杂得多,算法模型要识别出图片哪里有哪些目标并将其框出来。Ross Girshick大神提出了一种利用卷积神经网络加上支持向量机的算法模型用于目标检测。下面是对这个经典模型进行的简单解析。
基础结构
首先是目标定位问题,作者通过区域识别的方法来解决,这里采用的是$selective \ search$。即从图片中框选出候选区域参加后续模型的训练。其次是训练数据稀疏的问题,论文提出了在一个大的辅助数据集中有监督的预训练,之后在一个小数据集中进行特定部分的微调。实验结果也证实了这种方法是有效的。大致结构如下:
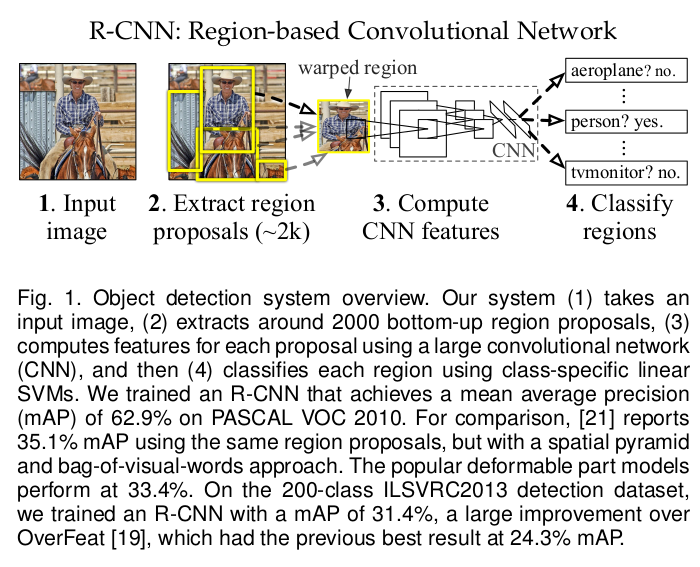
主要有三个组成部分:
- 生成与类别无关的候选区域;
- 用来从每一个区域中提取固定长度的特征向量的卷积网络;
- 一组特定于类的线性SVM
模块设计
在选择候选区域方面,有许多种实现方法,例如$objectness$,$selective \ search$,$category-independent \ object \ proposal$等。作者选择了$selective \ search$,这里不得不说$R-CNN$对于候选框的提出方法是不太合理的,因为$selective \ search$方法实在太慢了,严重拖慢了模型的速度。特征提取方面,作者使用$CNN$从每个候选框区域中提取出固定长度的特征。首先将候选区域周围紧密边界框的所有像素扭曲到到适合$CNN$网络的输入尺寸,在此前,作者扩展了紧密边界框以便在扭曲的尺寸上,原始周围的扭曲图像上下文恰有足够的像素框。在识别阶段,经过$SVM$得到各个候选框分数后再用贪婪的非极大值抑制($NMS$)对结果进行整合。考虑到训练数据过大,作者还采用了标准的难分样本挖掘来对模型性能进行提升。
模型的训练过程也分为三部分:
- CNN微调
- SVM训练
- 边界框回归训练
由于前面两个的训练基本上都跟以往一样,就不细说了,这里主要提一下边界框回归训练。
这一部分的输入是$N$个训练数据对$\{(P^i, G^i)\}_{i=1,\dots,N}$,其中$P^i=(P^i_x,P^i_y,P^i_w,P^i_h)$表示候选框中心的像素坐标以及候选框的长宽信息,同理$G=(G_x,G_y,G_w,G_h)$对应真实对象边界框信息。我们的目标是学习一个候选框$P$到真实边界框$G$的映射。定义四个变量$d_x(P)$,$d_y(P)$,$d_w(P)$,$d_h(P)$,前两个指定$P$的边界框中心的尺度不变的平移,后两个指定$P$的边界框的宽度和高度的对数空间上的平移。则候选框$P$与预测的目标框$\hat{G}$的映射可以表示为:
$$ \begin{aligned} \hat{G}_x & = P_wd_x(P)+P_x \\ \hat{G}_y & = P_hd_y(P)+P_y \\ \hat{G}_w & = P_wexp(d_w(P)) \\ \hat{G}_h & = P_hexp(d_h(P)) \end{aligned} $$可以把它看成线性回归问题,则每个$d_x(P)$,$d_y(P)$,$d_w(P)$,$d_h(P)$都是由来自卷积网络候选框池化层的特征向量$\phi(P)$建模成的,即有:
$$ d_*(P)=w^T_*\phi(P) $$其中$w_*$是模型的参数,可以通过正则化最小二乘目标(岭回归)来学习:
$$ w_*=argmax_{\hat{w}_*}\sum_i^N(t_*^i-\hat{w}_*^T\phi(P^i))^2+\lambda\vert\vert\hat{w}_*\vert\vert^2 $$对于本文,回归目标$t_*$定义为:
$$ \begin{aligned} t_x & = (G_x-P_x)/P_w \\ t_y & = (G_y-P_y)/P_h \\ t_w & = log(G_w/P_w) \\ t_h & = log(G_h/P_h) \end{aligned} $$即输入$\phi$后,利用$(t_x,t_y,t_w,t_h)$来修正候选框位置。
参考
本文参考自以下论文:
Region-based Convolutional Networks for Accurate Object Detection and Segmentation