这种连更的感觉很是刺激,很是酸爽。不多说废话,如标题所述这是一个更快更强的目标检测算法,同时也出自Ross Girshick之手。。。讲道理,这位大佬连着几篇论文都在喷他自己之前写的模型,有点东西啊。Faster Rcnn采用了一种高效的算法来生成候选框,也引入了Anchor这个概念。
基本结构
在$Fast \ RCNN$中,并没有对候选框的提出方法进行过任何讨论,只是提及到了使用$selective \ search$进行候选框的选择,后期这也成为了拖慢模型运行速度的主要原因。作者在$Faster \ RCNN$这个模型中进行了改进,提出了一种新的候选框提取方法,即$RPN$。结合了这种方法后模型的运行速度得到了大幅提升,同时准确率也有了提高。$Faster \ RCNN$的大致结构如下:
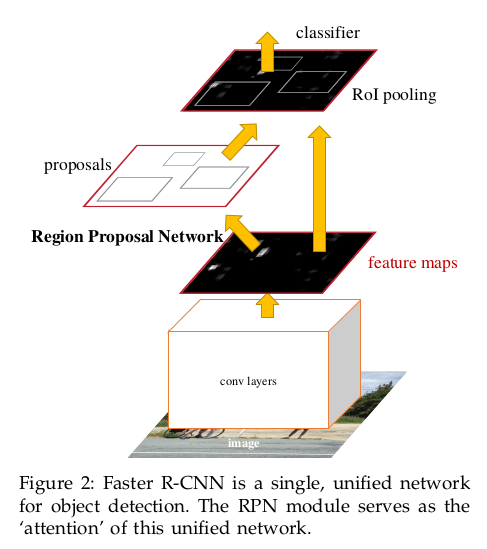
它的结构主要包含两部分,首先是一个深度全卷积网络用于生成候选区域,之后是$Fast \ RCNN$模型用于分类和边界框回归。$RPN$使用在经过卷积后的特征图上。
Region Proposal Networks
$RPN$网络以任意尺寸的图像作为输入计算输出一组对象候选框以及分类分数。为了生成候选区域,$RPN$在卷积特阵图上滑动一个小网络,这个小网络将特征图上的$n \times n$窗口作为输入。每一个滑窗生成一个低维特征,这个特征输入到两个分支中,一个是边界框回归层($reg$),一个是框分类层($cls$)。结构大致如下:
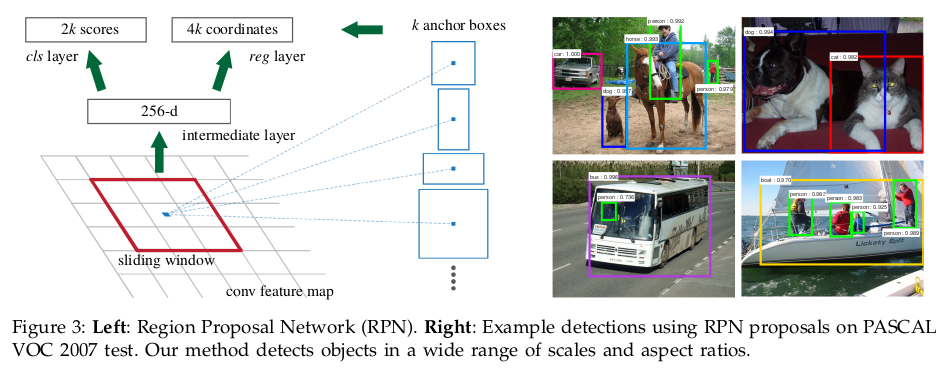
这里有一个重点,那就是$Anchor$。在每个滑窗的位置,我们需要同步地预测多个候选框,定义每个位置候选框的最大数量为$k$,所以$reg$层的输入为$4k$(编码了候选框的坐标),$cls$层的输入为$2k$(即候选框是否为目标)。而$Anchor$实际上是滑动窗口的中心,并和尺度和长宽比有关(个人理解是当前滑窗中心在原像素空间上的映射点即为$Anchor$)。论文实验中采用了3组尺度和3组长宽比,即每个滑窗位置生成9个$anchor$,对于尺寸为$W \times H$的卷积特征图,则一共生成$WHK$个$anchors$。跟以往的图像金字塔和特征金字塔相比,基于$Anchors$我们设计的多尺度检测只依赖于单一尺度的图像和特征映射,并使用单一尺寸的特征图上的滑动窗口。
$Anchor$还有一个重要性质,那就是平移不变性。若一张图片上的目标发生了平移,候选区域应该平移,这时相同的函数在任意位置都可以预测到候选框。通过这一性质也能降低模型的参数量。
为了对$RPN$进行训练,作者对每个$Anchor$都指定了一个二分类标签。对于以下两种情况的$anchor$指定为正类:
- 和真实例有着最高$IoU$的候选框;
- 和任一真实例有着超过0.7的$IoU$的候选框
当候选框的$IoU$低于0.3则标记为反类,$IoU$在0.3到0.7之间的$anchors$不参与$RPN$训练。训练的损失函数为:
$$ L(\{p_i\},\{t_i\}) = \frac{1}{N_{cls}}\sum_iL_{cls}(p_i,p_i^*)+\lambda\frac{1}{N_{reg}}\sum_ip_i^*L_{reg}(t_i,t_i^*) $$其中$i$是$anchor$在一个$minibatch$中的序号,$p_i$表示第$i$个$anchor$为对象的概率。$p_i^{\*}$为真实例标签表示,当$anchor$为正例时为1,为反例时为0。$t_i$是预测框的坐标向量,$t_i^{\*}$则是真实例的坐标向量。$L_{cls}$是两个类上的对数损失,对于框回归的损失,采用的是:
$$ L_{reg}(t_i,t_i^*)=R(t_i-t_i^*) $$其中$R$是$smooth \ L_1$函数。上式中的$p_i^*L_{reg}$项意味着回归项损失只在$anchor$为正类时计算。$cls$层和$reg$层的输出分别由$\{p_i\}$和$\{t_i\}$组成。
两项损失分别由$N_{cls}$和$N_{reg}$进行标准化并由$\lambda$控制平衡。但作者通过实验表明模型对大范围内的$\lambda$并不敏感,同时上面提及的标准化并不是必需的,可以进行简化。
边界框回归采取的方式跟$RCNN$一致,这里还对真实例的边界框进行了参数化处理$(t_x^*, t_y^*, t_w^*, t_h^*)$:
$$ \begin{aligned} t_x & = (x-x_a)/w_a \\ t_y & = (y-y_a)/h_a \\ t_w & = log(w/w_a) \\ t_h & = log(h/h_a) \\ t_x^* & = (x^*-x_a)/w_a \\ t_y^* & = (y^*-y_a)/h_a \\ t_w^* & = log(w^*/w_a) \\ t_h^* & = log(h^*/h_a) \end{aligned} $$用对数来表示长宽的差别还有一个作用是为了在差别大时能快速收敛,差别小时能较慢收敛来保证精度。
模型训练
对于检测网络,作者采用的是$Fast \ RCNN$。在训练时会分别对$RPN$和$Fast \ RCNN$进行训练。有三种用于训练这种包含特征共享该网络的方法:
- $Alternating \ training$。首先我们会先训练$RPN$,然后使用候选框去训练$Fast \ RCNN$,网络经过$Fast \ RCNN$微调后再返过来初始化$RPN$,这个过程可以迭代进行。
- $Approximate \ joint \ training$。这种方法将$RPN$和$Fast \ RCNN$融合为一个网络进行训练。在每一轮$SGD$中,前向传播经过$RPN$时并不改变其参数,使用预先计算的候选框对$Fast \ RCNN$进行训练,后向传播则正常进行。对于共享卷积层的后向传播,传播信息来自$RPN$的损失和$Fast \ RCNN$的损失。这种方法忽略了候选框坐标的导数信息。
- $Non-approximate \ joint \ training$。这种方法修正了上一种方法的缺陷,包含了候选框坐标的信息。这种方法我们需要一个可区分框坐标不同的$RoI \ pooling$池化层,这一点可以通过$RoI \ warping$层来解决。
作者采用的是$4-step \ Alternating \ Training$,四步具体如下:
- 训练$RPN$,网络用$ImageNet$预训练模型进行初始化并用区域候选框损失进行端到端的微调;
- 使用第一步生成的候选框对$Fast \ RCNN$进行训练,这个网络也用$ImageNet$预训练模型进行初始化。到这一步,两个网络并没有共享卷积层的计算;
- 使用检测网络对$RPN$进行训练,同时冻结卷积层,只调整属于$RPN$模型的层;
- 保持卷积层冻结,微调属于$Fast \ RCNN$模型的层。这样两个网络都共享了卷积层的计算。
$Faster \ RCNN$和$Fast \ RCNN$都是属于$two \ stage$算法,即二阶段算法。这类算法的特征是先由算法生成一系列作为样本地候选框,然后再对这些框进行分类和回归操作。这样计算精度高但速度慢。而单阶段算法($one \ stage$)则是将目标定位问题转为回归问题,速度上有了较大地提升但精度却下降了。
参考
关于$Faster \ RCNN$模型还有许多细节这里没有提及,具体可以参照论文原文以及作者开源的相关代码。
本文主要参考自以下文章:
Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks