利用三种视图进行3D点云检测(鸟瞰图、前视图、原RGB图)。
Bird’s view
将点云数据等分为$M$份,在每一份上以$0.1m$的粒度划分网格,并提取每一格内的最高点云高度,作为鸟瞰图的高度图。强度图则采用网格内高度最高的点对应的反射率值,密度图则统计每个网格内的点云数$N$,对特征进行归一化,最后结果为$\min (1,\frac{\log (N+1)}{\log 64})$,其中64应该为激光线程数。最后得到通道数为$M+2$的特征。
Front’s view
考虑到激光点云十分稀疏,将点云投影到圆柱面上形成前视图。给定一个3D点$p=(x,y,z)$,对应的前视图坐标为$p_{fv}=(r,c)$,有:
$$ \begin{aligned} r &= \lfloor\arctan \frac{z}{\sqrt{x^2+y^2}}/\Delta\phi\rfloor \\ c &= \lfloor\arctan \frac{y}{x}/\Delta\theta\rfloor \end{aligned} $$其中$\Delta\phi$、$\Delta\theta$分别表示垂直、水平方向上的分辨率。
3D prior box
受到RPN的启发,作者也设计了一个网络结构来生成3D prior box。该结构只在鸟瞰图中使用,prior box以参数$(x_{bv},y_{bv},l_{bv},w_{bv})$表示。其中$l_{bv}$和$w_{bv}$可由训练集聚类得到,然后由于在鸟瞰图中,目标框还具有旋转角,所以prior box也需要有旋转角,作者设定为$\lbrace 0^\circ,90^\circ\rbrace$。
prior box的正负样本分配主要参考prior box与真实框的IOU大小,当IOU大于0.7时则认定为正样本,低于0.5时则认定为负样本,介于两者之间为忽略样本,为了减少计算量,作者忽略样本全部删除。在剩余的有效prior box中,还会使用IOU阈值为0.7的NMS进一步减少框的个数,在训练阶段,仅保留NMS中的Top 2000个框,而测试时保留Top 300个。
该结构对类别使用交叉熵损失,对位置大小使用$smooth\ l1$损失。其中位置尺寸的回归变量为$t=(\Delta x,\Delta y,\Delta z,\Delta l,\Delta w,\Delta h)$,$(\Delta x,\Delta y,\Delta z)$为中心偏移量,并使用相应的prior box尺寸进行归一化,$(\Delta l,\Delta w,\Delta h)$的计算为:$\Delta S = \log \frac{S_{GT}}{S_{anchor}}$,$S\in\lbrace l,w,h\rbrace$。
Network
模型最终训练时通过回归3D box的8个角的角偏移量$(\Delta x_0,\Delta x_1,\dots,\Delta y_0,\Delta y_1,\dots,\Delta z_0,\Delta z_1,\dots)$来修正框的位置和大小。该偏移量采用对应prior box的对角线长度进行归一化。
正负预测结果由prior box与预测框的IOU决定,大于0.5则认定预测为正,反之为负。损失函数方面参照上面RPN结构,类别损失用交叉熵损失,回归损失用$smooth\ l1$损失。推断时,在最后使用IOU阈值为0.05的NMS移除预测多余框。
模型结构如下:
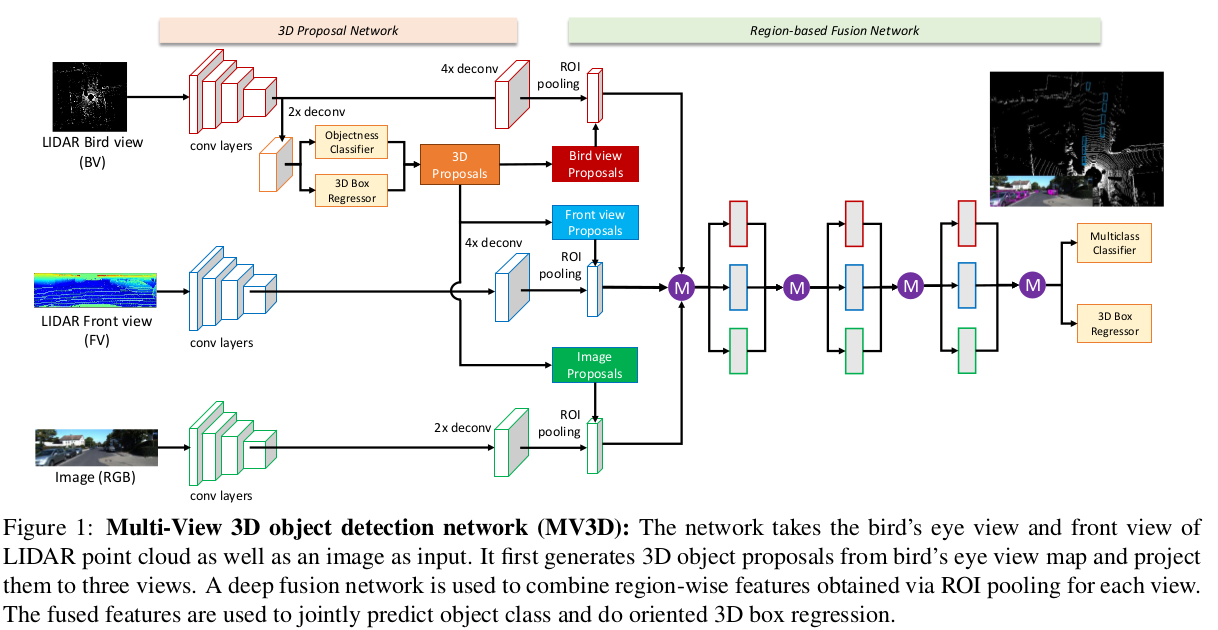
图中各个视图通过ROI pooling转换为相同大小的特征向量再拼接在一起,最后通过Deep fusion的形式更深一步地融合特征。
结构正则化
网络结构还使用了drop-path和auxiliary losses两种方法。
每次迭代中,随机选择global drop path和local drop path。如果为global drop path,则随机从三个视图中选择一个视图,只保留该视图上的路径,其余视图路径抑制,如果为local drop path,则输入到每个连接节点的路径以 50% 的概率随机丢弃。
auxilary losses结构如下:

该结构与对应的网络层共享权重,并参与训练损失回传,在推断时去掉该结构。
参考
Multi-View 3D Object Detection Network for Autonomous Driving