这是一个diffusion model类型的图像生成模型,简单地概括就是通过在原图$\mathbf{x}_0$上不断地叠加高斯噪声(一共$T$轮),最终可以将$\mathbf{x}_0$变为纯高斯噪声$\mathbf{x}_T$,而模型负责将$\mathbf{x}_T$还原为$\mathbf{x}_0$。图示如下:
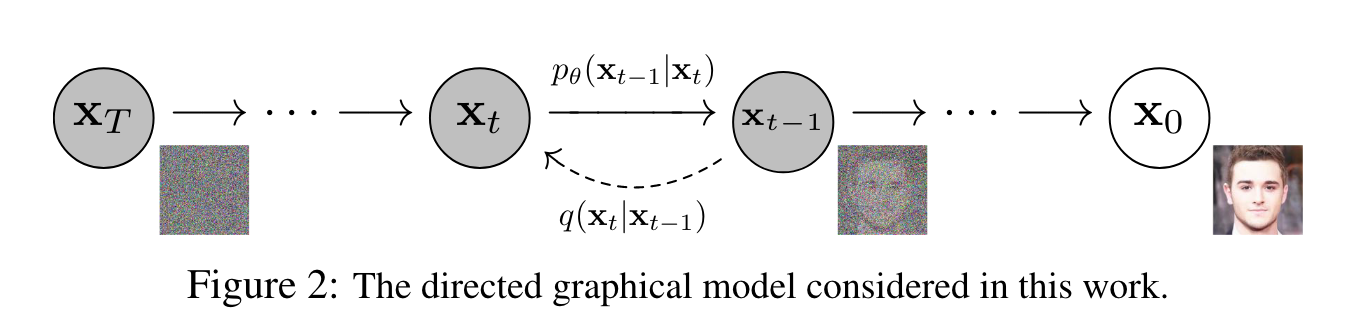
其中$\mathbf{x}_0$到$\mathbf{x}_T$的过程称为前向过程,而$\mathbf{x}_T$到$\mathbf{x}_0$的过程为逆向过程或推断过程。
本文大部分内容参考自What are Diffusion Models。
前向过程(forward)
输入图片$\mathbf{x}_0 \sim q(\mathbf{x})$,进行$T$次高斯噪声的叠加得到$\mathbf{x}_1$、$\mathbf{x}_2$、$\dots$、$\mathbf{x}_T$。这个过程中$\mathbf{x}_t$只与$\mathbf{x}_{t-1}$有关,所以可以认为是一个马尔科夫过程。有下式:
$$ \begin{aligned} q(\mathbf{x}_t \vert \mathbf{x}_{t-1}) &= \mathcal{N}(\mathbf{x}_t; \sqrt{1 - \beta_t} \mathbf{x}_{t-1}, \beta_t\mathbf{I}) \\ q(\mathbf{x}_{1:T} \vert \mathbf{x}_0) &= \prod^T_{t=1} q(\mathbf{x}_t \vert \mathbf{x}_{t-1}) \end{aligned} $$其中$\{\beta_t\in (0, 1)\}^T_{t=1}$是给定的超参数,表示一系列高斯分布的方差。实际中$\beta_t$会随着$t$的增大而增大。
令$\alpha_t = 1 - \beta_t$,且$\overline{\alpha}_t = \Pi_{i=1}^t\alpha_i$。使用重参数化技巧有:
$$ \begin{aligned} \mathbf{x}_t &= \sqrt{\alpha_t}\mathbf{x}_{t-1} + \sqrt{1 - \alpha_t}\boldsymbol{\epsilon}_{t-1} \\ &= \sqrt{\alpha_t \alpha_{t-1}} \mathbf{x}_{t-2} + \sqrt{1 - \alpha_t \alpha_{t-1}} \bar{\boldsymbol{\epsilon}}_{t-2} & \\ &= \dots \\ &= \sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t}\boldsymbol{\epsilon} \\ q(\mathbf{x}_t \vert \mathbf{x}_0) &= \mathcal{N}(\mathbf{x}_t; \sqrt{\bar{\alpha}_t} \mathbf{x}_0, (1 - \bar{\alpha}_t)\mathbf{I}) \end{aligned} $$其中$\boldsymbol{\epsilon}_{t-1}, \boldsymbol{\epsilon}_{t-2}, \dots \sim \mathcal{N}(\mathbf{0}, \mathbf{I})$,$\bar\epsilon_{t-2}$表示两个高斯分布的合并,即通过独立高斯分布的可加性来进行合并:
$$ \mathcal{N}(\mathbf{0}, \sigma_2^2\mathbf{I}) + \mathcal{N}(\mathbf{0}, \sigma_2^2\mathbf{I}) \sim \mathcal{N}(\mathbf{0}, (\sigma^2_1+\sigma^2_2)\mathbf{I}) $$综上我们可以得到:
$$ \begin{aligned} \mathbf{x}_t = \sqrt{\overline{\alpha}_t}\mathbf{x}_0 + \sqrt{1-\overline{\alpha}_t}\boldsymbol\epsilon \end{aligned} \tag{1} $$即任意时刻的$\mathbf{x}_t$可由$\mathbf{x}_0$和$\beta$表示。同时通过$(1)$式可以看到随着$t$增大,$\beta_t$也会增大,$\overline\alpha_t$则越接近于0,所以$\mathbf{x}_t$也越接近于标准的高斯分布$\mathcal{N}(\mathbf{0}, \mathbf{I})$。
逆向过程(reverse)
假如我们可以得到逆转后的分布$q(\mathbf{x}_{t-1} \vert \mathbf{x}_t)$,就可以从完全的标准高斯分布$\mathbf{x}_t\sim\mathcal{N}(\mathbf{0}, \mathbf{I})$还原出$\mathbf{x}_0$。注意当$\beta_t$足够小时,$q(\mathbf{x}_{t-1}\vert\mathbf{x}_t)$仍然为高斯分布,但通常我们无法简单地推断出$q(\mathbf{x}_{t-1}\vert\mathbf{x}_t)$,所以我们使用深度学习模型(以$\theta$为参数,目前主流结构为Unet+Attention)去预测一个分布$p_\theta$来近似分布$q(\mathbf{x}_{t-1}\vert\mathbf{x}_t)$。
$$ \begin{aligned} p_\theta(\mathbf{x}_{0:T}) &= p(\mathbf{x}_T) \prod^T_{t=1} p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t) \\ p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t) &= \mathcal{N}(\mathbf{x}_{t-1}; \boldsymbol{\mu}_\theta(\mathbf{x}_t, t), \boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t)) \end{aligned} $$通过上式可以得知,为了得到分布$p_\theta$,需要获得$\boldsymbol{\mu}_\theta(\mathbf{x}_t, t)$和$\boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t)$。
对于逆转后的分布$q(\mathbf{x}_{t-1}\vert\mathbf{x}_t)$,将$\mathbf{x}_0$作为已知条件加入,有:
$$ q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) = \mathcal{N}(\mathbf{x}_{t-1}; {\tilde{\boldsymbol{\mu}}}(\mathbf{x}_t, \mathbf{x}_0), {\tilde{\beta}_t} \mathbf{I}) $$这里的方差用$\tilde{\beta_t}$是因为DDPM论文做了简化,将$\boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t)$直接取值为$\tilde{\beta_t}$。
由贝叶斯公式可得:
$$ q(\mathbf{x}_{t-1}\vert\mathbf{x}_t,\mathbf{x}_0) = \frac{q(\mathbf{x}_t\vert\mathbf{x}_{t-1},\mathbf{x}_0)q(\mathbf{x}_{t-1}\vert\mathbf{x}_0)}{q(\mathbf{x}_t\vert\mathbf{x}_0)} $$即将逆向过程全部转换为了前向过程。代入高斯分布的密度函数可得:
$$ \begin{aligned} & q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \\ = & \frac{q(\mathbf{x}_t\vert\mathbf{x}_{t-1},\mathbf{x}_0)q(\mathbf{x}_{t-1}\vert\mathbf{x}_0)}{q(\mathbf{x}_t\vert\mathbf{x}_0)} \\ \propto & \exp\Big( -\frac{1}{2} \big( (\frac{\alpha_t}{\beta_t} + \frac{1}{1 - \bar{\alpha}_{t-1}}) \mathbf{x}_{t-1}^2 - (\frac{2\sqrt{\alpha_t}}{\beta_t} \mathbf{x}_t + \frac{2\sqrt{\bar{\alpha}_{t-1}}}{1 - \bar{\alpha}_{t-1}} \mathbf{x}_0) \mathbf{x}_{t-1} + C(\mathbf{x}_t, \mathbf{x}_0) \big) \Big) \end{aligned} $$通常的高斯分布$\mathcal{N}(\mu, \sigma^2)$密度函数如下:
$$ \begin{aligned} f(x) &= \frac{1}{\sqrt{2\pi}\sigma}\exp(-\frac{(x-\mu)^2}{2\sigma^2}) \\ &=\frac{1}{\sqrt{2\pi}\sigma}\exp(-\frac{1}{2}(\frac{1}{\sigma^2}x^2-\frac{2\mu}{\sigma^2}x+\frac{\mu^2}{\sigma^2})) \end{aligned} $$对照上式,有:
$$ \begin{aligned} \frac{1}{\sigma^2} &= \frac{1}{\tilde{\beta}_t} = \frac{\alpha_t}{\beta_t}+\frac{1}{1-\bar\alpha_{t-1}} \\ &\Rightarrow \tilde{\beta}_t = \frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\cdot\beta_t \\ \frac{2\mu}{\sigma^2} &= \frac{2\sqrt{\alpha_t}}{\beta_t} \mathbf{x}_t + \frac{2\sqrt{\bar{\alpha}_{t-1}}}{1 - \bar{\alpha}_{t-1}} \mathbf{x}_0 \\ &\Rightarrow \tilde\mu_t(\mathbf{x}_t, \mathbf{x}_0) = \frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}\mathbf{x}_t+\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t}\mathbf{x}_0 \end{aligned} $$可知方差$\tilde{\beta}_t$是一个定量,而均值$\tilde\mu_t$与$\mathbf{x}_t$和$\mathbf{x}_0$有关。由$(1)$式可得$\mathbf{x}_0 = \frac{1}{\sqrt{\bar{\alpha}_t}}(\mathbf{x}_t - \sqrt{1 - \bar{\alpha}_t}\boldsymbol{\epsilon}_t)$,代入上式有:
$$ \begin{aligned} \tilde{\boldsymbol{\mu}}_t =\frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_t \Big) \end{aligned} \tag{2} $$其中高斯分布$\boldsymbol{\epsilon}_t$在模型中则为预测的噪声分布,为$\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)$,则有:
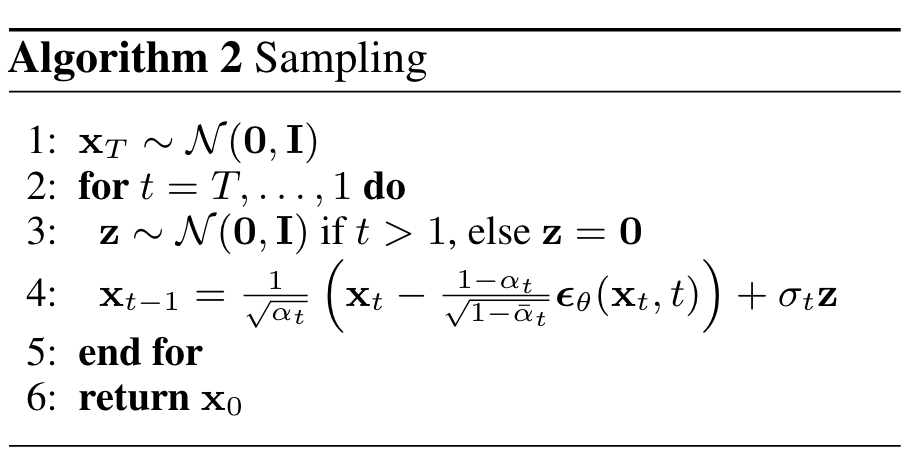
$$ \begin{aligned} \boldsymbol{\mu}_\theta(\mathbf{x}_t, t) =\frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t) \Big) \end{aligned} \tag{3} $$综合上面的逆向过程,我们可以得到模型推断的步骤如下:
- 通过$\mathbf{x}_t$和$t$由模型预测出高斯噪声$\boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)$,之后由$(3)$式得到$\boldsymbol{\mu}_\theta(\mathbf{x}_t, t)$
- 计算方差$\Sigma_\theta(\mathbf{x}_t, t)$。DDPM用$\tilde\beta_t$来代替$\Sigma_\theta(\mathbf{x}_t, t)$,且认为$\beta_t$与$\tilde\beta_t$近似
- 由$p_\theta(\mathbf{x}_{t-1} \vert \mathbf{x}_t) = \mathcal{N}(\mathbf{x}_{t-1}; \boldsymbol{\mu}_\theta(\mathbf{x}_t, t), \boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t))$以及重参数法可以得到$\mathbf{x}_{t-1}$
DDPM的推断流程如下:
训练过程(training)
上面提到我们使用模型去预测一个分布$p_\theta(\mathbf{x}_{t-1}\vert\mathbf{x}_t)$来近似表达逆转后的分布$q(\mathbf{x}_{t-1}\vert\mathbf{x}_t)$。针对该问题一般有两种方法,一种是优化负对数的最大似然概率$-\log p_\theta(\mathbf{x}_0)$;另一种是优化预测分布与真实分布的交叉熵$\mathbb{E}_{q(\mathbf{x}_0)}[-\log p_\theta(\mathbf{x}_0)]$。两种方法直接进行优化都比较困难,所以考虑去优化它们的变分下限(VLB)。
由于KL散度非负,故有:
$$ -\log p_\theta(\mathbf{x}_0) \leq -\log p_\theta(\mathbf{x}_0) + D_{KL}(q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)\vert\vert p_\theta(\mathbf{x}_{1:T}\vert\mathbf{x}_0)) $$将KL散度展开化简,并对式子两边同时取期望$\mathbb{E}_{q(\mathbf{x}_0)}$可得:
$$ \begin{aligned} \mathcal{L}_{VLB} &= \mathbb{E}_{q(\mathbf{x}_0)}\Big( -\log p_\theta(\mathbf{x}_0) + \mathbb{E}_{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}\Big[\log\frac{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}{p_\theta(\mathbf{x}_{0:T})} + \log p_\theta (\mathbf{x}_0)\Big]\Big)\\ &= \mathbb{E}_{q(\mathbf{x}_0)}\Big( \mathbb{E}_{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}\Big[\log\frac{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}{p_\theta(\mathbf{x}_{0:T})}\Big]\Big) \\ &= \mathbb{E}_{q(\mathbf{x}_{0:T})}\Big[\log\frac{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}{p_\theta(\mathbf{x}_{0:T})}\Big] \\ &\geq \mathbb{E}_{q(\mathbf{x}_0)}[-\log p_\theta(\mathbf{x}_0)] \end{aligned} $$上面式子的第二个等号用的是Fubini定理,也可由Jensen不等式得到一样的结果:
$$ \begin{aligned} & \mathbb{E}_{q(\mathbf{x}_0)}[-\log p_\theta(\mathbf{x}_0)] \\ =& -\mathbb{E}_{q(\mathbf{x}_0)}\Big[\log\Big(p_\theta(\mathbf{x}_0)\cdot\int p_\theta(\mathbf{x}_{1:T})d\mathbf{x}_{1:T}\Big)\Big] \\ =& -\mathbb{E}_{q(\mathbf{x}_0)}\Big[\log\Big(\int p_\theta(\mathbf{x}_{0:T})d\mathbf{x}_{1:T}\Big)\Big] \\ =& -\mathbb{E}_{q(\mathbf{x}_0)}\Big[\log\Big(\int q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)\frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}d\mathbf{x}_{1:T}\Big)\Big] \\ =& -\mathbb{E}_{q(\mathbf{x}_{0:T})}\Big[\log\Big(\mathbb{E}_{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}\frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}\Big)\Big] \\ \leq & -\mathbb{E}_{q(\mathbf{x}_{0:T})}\Big[\log\frac{p_\theta(\mathbf{x}_{0:T})}{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}\Big] \\ =& \mathbb{E}_{q(\mathbf{x}_{0:T})}\Big[\log\frac{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}{p_\theta(\mathbf{x}_{0:T})}\Big] = \mathcal{L}_{VLB} \end{aligned} $$注意$\log$为凹函数,$-\log$为凸函数。
故最终得到下式:
$$ \mathcal{L}_{VLB} = \mathbb{E}_{q(\mathbf{x}_{0:T})}\Big[\log\frac{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}{p_\theta(\mathbf{x}_{0:T})}\Big] \geq \mathbb{E}_{q(\mathbf{x}_0)}[-\log p_\theta(\mathbf{x}_0)] $$所以我们最小化$\mathbf{L}_{VLB}$即可最小化目标损失函数$\mathbb{E}_{q(\mathbf{x}_0)}[-\log p_\theta(\mathbf{x}_0)]$。
对$\mathbf{L}_{VLB}$进行推导有:
$$ \begin{aligned} \mathcal{L}_{VLB} &= \mathbb{E}_{q(\mathbf{x}_{0:T})} \Big[ \log\frac{q(\mathbf{x}_{1:T}\vert\mathbf{x}_0)}{p_\theta(\mathbf{x}_{0:T})} \Big] \\ &= \mathbb{E}_q \Big[ \log\frac{\prod_{t=1}^T q(\mathbf{x}_t\vert\mathbf{x}_{t-1})}{ p_\theta(\mathbf{x}_T) \prod_{t=1}^T p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t) } \Big] \\ &= \mathbb{E}_q \Big[ -\log p_\theta(\mathbf{x}_T) + \sum_{t=1}^T \log \frac{q(\mathbf{x}_t\vert\mathbf{x}_{t-1})}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)} \Big] \\ &= \mathbb{E}_q \Big[ -\log p_\theta(\mathbf{x}_T) + \sum_{t=2}^T \log \frac{q(\mathbf{x}_t\vert\mathbf{x}_{t-1})}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)} + \log\frac{q(\mathbf{x}_1 \vert \mathbf{x}_0)}{p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)} \Big] \\ &= \mathbb{E}_q \Big[ -\log p_\theta(\mathbf{x}_T) + \sum_{t=2}^T \log \Big( \frac{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)}\cdot \frac{q(\mathbf{x}_t \vert \mathbf{x}_0)}{q(\mathbf{x}_{t-1}\vert\mathbf{x}_0)} \Big) + \log \frac{q(\mathbf{x}_1 \vert \mathbf{x}_0)}{p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)} \Big] \\ &= \mathbb{E}_q \Big[ -\log p_\theta(\mathbf{x}_T) + \sum_{t=2}^T \log \frac{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)} + \sum_{t=2}^T \log \frac{q(\mathbf{x}_t \vert \mathbf{x}_0)}{q(\mathbf{x}_{t-1} \vert \mathbf{x}_0)} + \log\frac{q(\mathbf{x}_1 \vert \mathbf{x}_0)}{p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)} \Big] \\ &= \mathbb{E}_q \Big[ -\log p_\theta(\mathbf{x}_T) + \sum_{t=2}^T \log \frac{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)} + \log\frac{q(\mathbf{x}_T \vert \mathbf{x}_0)}{q(\mathbf{x}_1 \vert \mathbf{x}_0)} + \log \frac{q(\mathbf{x}_1 \vert \mathbf{x}_0)}{p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)} \Big]\\ &= \mathbb{E}_q \Big[ \log\frac{q(\mathbf{x}_T \vert \mathbf{x}_0)}{p_\theta(\mathbf{x}_T)} + \sum_{t=2}^T \log \frac{q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0)}{p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t)} - \log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \Big] \\ &= \mathbb{E}_q [\underbrace{D_\text{KL}(q(\mathbf{x}_T \vert \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_T))}_{L_T} + \sum_{t=2}^T \underbrace{D_\text{KL}(q(\mathbf{x}_{t-1} \vert \mathbf{x}_t, \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_{t-1} \vert\mathbf{x}_t))}_{L_{t-1}} \underbrace{- \log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1)}_{L_0} ] \end{aligned} $$即将$\mathcal{L}_{VLB}$转为多个熵或KL散度的和的形式。最后由下面式子表示:
$$ \begin{aligned} \mathcal{L}_{VLB} &= L_T + L_{T-1} + \dots + L_0 \\ \text{where } L_T &= D_\text{KL}(q(\mathbf{x}_T \vert \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_T)) \\ L_t &= D_\text{KL}(q(\mathbf{x}_t \vert \mathbf{x}_{t+1}, \mathbf{x}_0) \parallel p_\theta(\mathbf{x}_t \vert\mathbf{x}_{t+1})) \text{ for }1 \leq t \leq T-1 \\ L_0 &= - \log p_\theta(\mathbf{x}_0 \vert \mathbf{x}_1) \end{aligned} $$前向过程$q$并没有可供学习的参数,且$\mathbf{x}_T$为纯高斯噪声,所以$L_T$可以视为常量。$L_t$可以看作是拉近两个高斯分布的距离,由多元高斯分布的KL散度求解有:
$$ \mathcal{L}_{VLB} = \mathbb{E}_q\Big[\frac{1}{2{\vert\vert\Sigma_\theta(\mathbf{x}_t, t)\vert\vert}^2_2}{\vert\vert\tilde\mu_t(\mathbf{x}_t, \mathbf{x}_0)-\mu_\theta(\mathbf{x}_t, t)\vert\vert}^2\Big] + C $$其中$C$与模型参数无关,将$(1), (2), (3)$代入上式,可得:
$$ \begin{aligned} L_t &= \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \Big[\frac{1}{2 \| \boldsymbol{\Sigma}_\theta(\mathbf{x}_t, t) \|^2_2} \| \tilde{\boldsymbol{\mu}}_t(\mathbf{x}_t, \mathbf{x}_0) - \boldsymbol{\mu}_\theta(\mathbf{x}_t, t) \|^2 \Big] \\ &= \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \Big[\frac{1}{2 \|\boldsymbol{\Sigma}_\theta \|^2_2} \| \frac{1}{\sqrt{\alpha_t} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_t \Big)} - \frac{1}{\sqrt{\alpha_t}} \Big( \mathbf{x}_t - \frac{1 - \alpha_t}{\sqrt{1 - \bar{\alpha}_t} \boldsymbol{\boldsymbol{\epsilon}}_\theta(\mathbf{x}_t, t) \Big)} \|^2 \Big] \\ &= \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \Big[\frac{ (1 - \alpha_t)^2 }{2 \alpha_t (1 - \bar{\alpha}_t) \| \boldsymbol{\Sigma}_\theta \|^2_2} \|\boldsymbol{\epsilon}_t - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)\|^2 \Big] \\ &= \mathbb{E}_{\mathbf{x}_0, \boldsymbol{\epsilon}} \Big[\frac{ (1 - \alpha_t)^2 }{2 \alpha_t (1 - \bar{\alpha}_t) \| \boldsymbol{\Sigma}_\theta \|^2_2} \|\boldsymbol{\epsilon}_t - \boldsymbol{\epsilon}_\theta(\sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t}\boldsymbol{\epsilon}_t, t)\|^2 \Big] \end{aligned} $$上式可以看出,模型训练的重点就是优化两个高斯噪声$\boldsymbol\epsilon$和$\boldsymbol\epsilon_\theta$之间的MAE。
对于$L_0$,DDPM针对$p_\theta(\mathbf{x}_0\vert\mathbf{x}_1)$设计了一个离散化的分段积分累计,同时将$\mathcal{L}_{VLB}$进行化简(忽略了系数),有:
$$ \begin{aligned} L_t^\text{simple} &= \mathbb{E}_{t \sim [1, T], \mathbf{x}_0, \boldsymbol{\epsilon}_t} \Big[\|\boldsymbol{\epsilon}_t - \boldsymbol{\epsilon}_\theta(\mathbf{x}_t, t)\|^2 \Big] \\ &= \mathbb{E}_{t \sim [1, T], \mathbf{x}_0, \boldsymbol{\epsilon}_t} \Big[\|\boldsymbol{\epsilon}_t - \boldsymbol{\epsilon}_\theta(\sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t}\boldsymbol{\epsilon}_t, t)\|^2 \Big] \\ \Rightarrow & L_{simple} = L^{simple}_t + C \end{aligned} $$如前面所提,DDPM并没有去计算$\Sigma_\theta(\mathbf{x}_t, t)$,而是用一个不可训练的$\beta_t$或$\tilde\beta_t$。所以DDPM的训练流程大致如下:
- 获取$\mathbf{x}_0$,从$1\dots T$中随机采样一个$t$
- 从标准高斯分布随机采样一个噪声$\epsilon_t \sim \mathcal{N}(\mathbf{0}, \mathbf{I})$
- 最小化$\|\boldsymbol{\epsilon}_t - \boldsymbol{\epsilon}_\theta(\sqrt{\bar{\alpha}_t}\mathbf{x}_0 + \sqrt{1 - \bar{\alpha}_t}\boldsymbol{\epsilon}_t, t) \|$
DDPM的训练流程图如下:

Appendix
A. 重参数(reparameterization)
通常从某一个分布中随机采样一个样本的这个过程并不能进行反向传播。重参数使用了一个独立的随机变量将随机性引导出去。
假设$\mathbf{z}$服从一个期望为$\mu_\theta$,方差为$\sigma_\theta^2$的高斯分布。重随机采样用重参数可写成如下形式:
$$ \mathbf{z} = \mu_\theta + \sigma_\theta \odot \epsilon, \quad \epsilon\sim\mathcal{N}(\mathbf{0}, \mathbf{I}) $$其中$\odot$表示逐元素相乘。上式将$\mathbf{z}$的随机性转移到了$\epsilon$上,同时满足$\mathbf{z}\sim \mathcal{N}(\mathbf{z}; \mu_\theta, \sigma^2_\theta\mathbf{I})$,并且这个过程可导。
B. Jensen不等式
$x$为一随机变量,且$\phi$为凸函数,则有下式成立:
$$ \phi(E(x)) \leq E(\phi(x)) $$若$x$为离散随机变量,则可写为:$\phi(\frac{1}{n}\sum x)\leq\frac{1}{n}\sum\phi(x)$
C. KL散度
分布$p(x)$和$q(x)$的KL散度记为$D_{KL}(p\|q)$,有:
$$ D_{KL}(p\|q) = E_{p(x)}[\log\frac{p(x)}{q(x)}] $$由Jensen不等式可以推导出KL散度恒大于0:
$$ \begin{aligned} D_{KL}(p\|q) &= E_{p(x)}[\log\frac{p(x)}{q(x)}] \\ &= E_{p(x)}[-\log\frac{q(x)}{p(x)}] \\ &\ge-\log\Big( E_{p(x)}[\frac{q(x)}{p(x)}] \Big) \\ &=-\log\Big(\int p(x)\frac{q(x)}{p(x)} dx\Big) \\ &=-\log\Big(\int q(x)dx\Big) \\ &=-\log(1) = 0 \end{aligned} $$